L'IA sur vos propres serveurs
Des nœuds GPU de votre propre cluster exécutent les modèles. Le NVIDIA GPU Operator installe les pilotes, HAMi permet à plusieurs charges de partager un même GPU et KEDA les met à l'échelle. Vous apportez les modèles, et ils tournent sur du matériel que vous contrôlez.
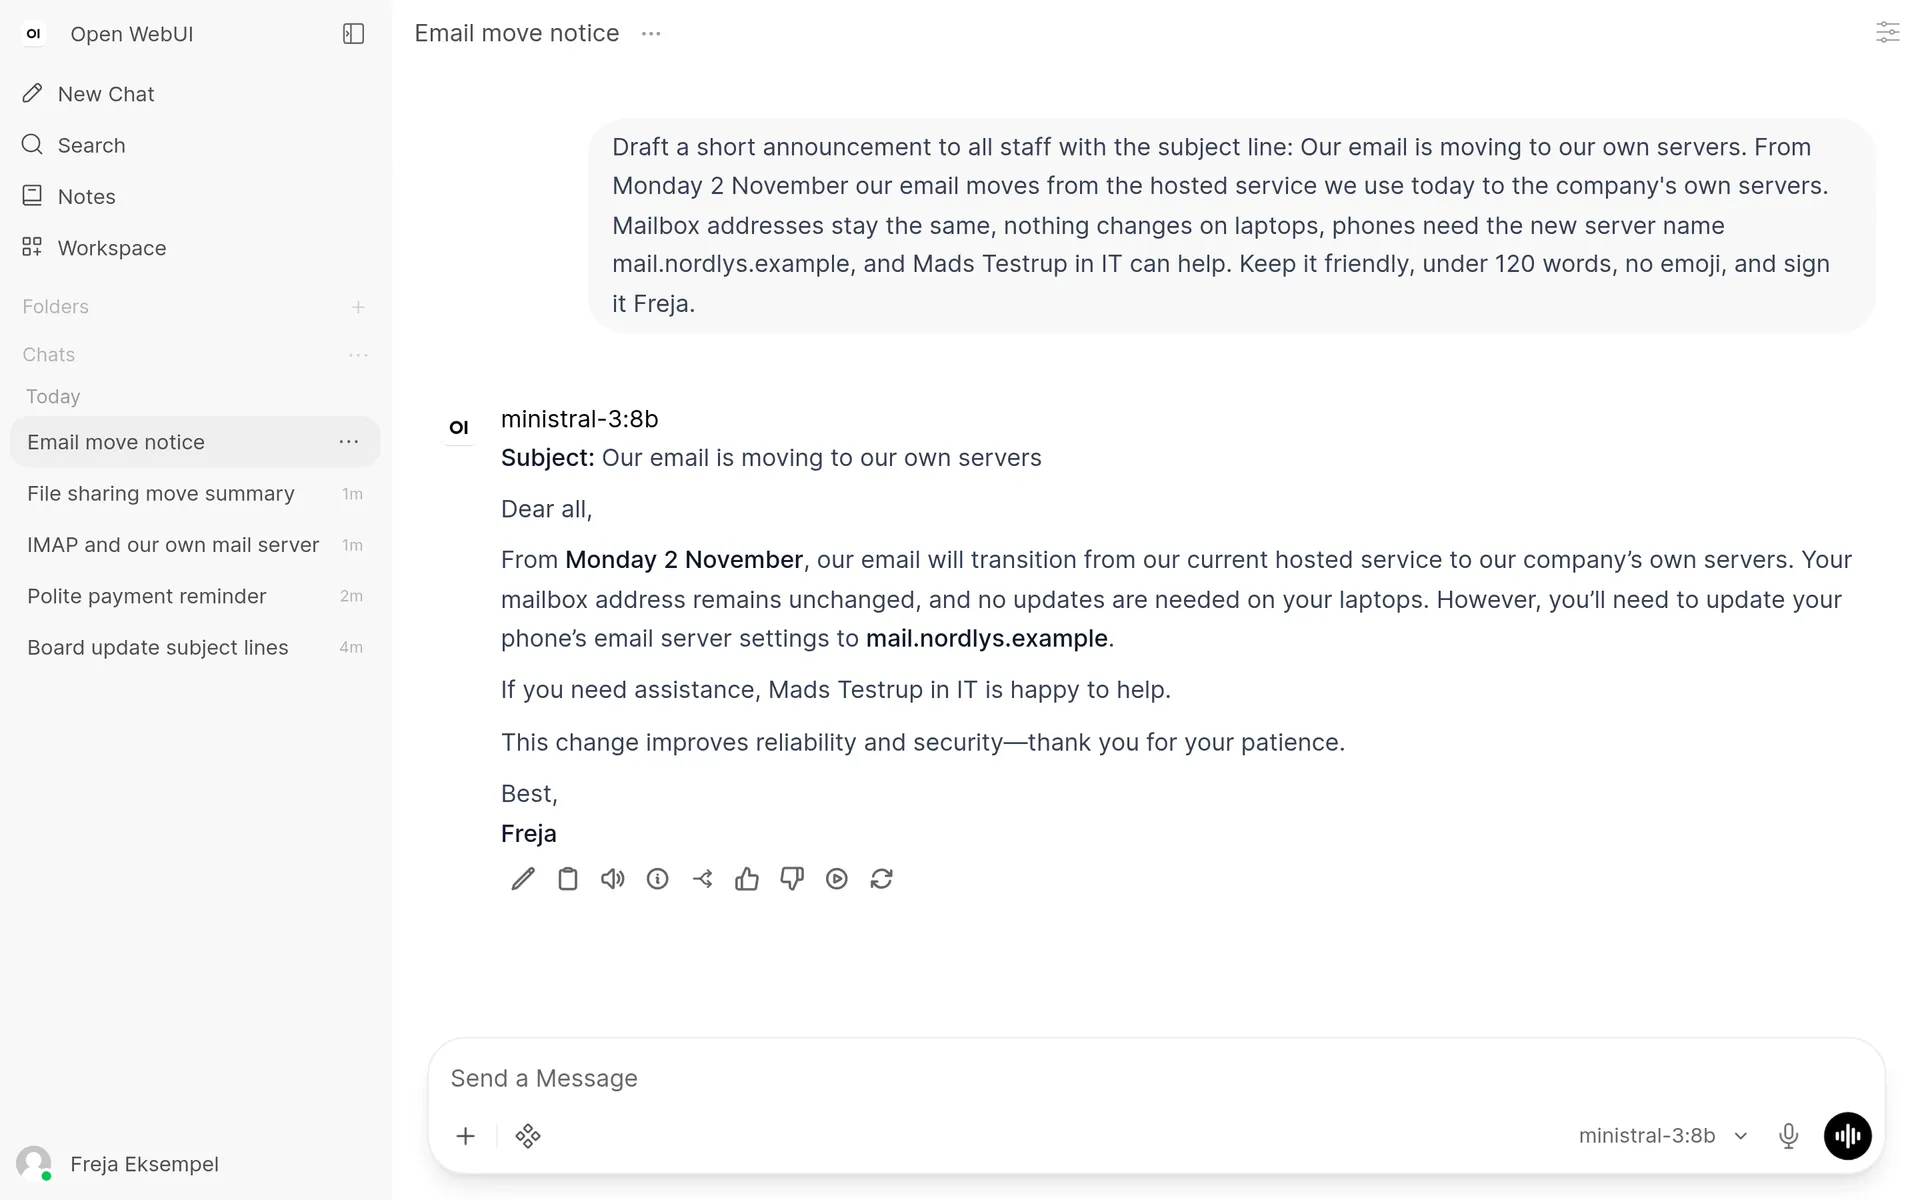
Les captures d'écran proviennent des applications installées sur un serveur de test, avec des données fictives.
Ce qui reste sous votre contrôle
Le modèle tourne sur des nœuds GPU de votre propre cluster : les prompts et les documents restent sur du matériel que vous contrôlez.
Les modèles à poids ouverts sont des fichiers que vous pouvez télécharger, exécuter hors ligne et conserver. Les modèles entièrement ouverts, comme Apertus et OLMo, publient aussi leurs données d'entraînement : vous pouvez vérifier comment ils ont été construits.
L'interface de chat et les outils de développement sont des programmes distincts qui dialoguent avec votre modèle : vous pouvez remplacer chacun d'eux.
La licence détermine ce que vous pouvez faire d'un modèle. Certains modèles à poids ouverts comportent des restrictions pour les entreprises de l'UE ou au-delà d'un certain chiffre d'affaires. Le tableau ci-dessous les recense.
Les applications open source derrière
- NVIDIA GPU Operator
- HAMi
- KEDA
Alternative à
Les assistants IA fermés d'éditeurs hors UE, comme ChatGPT, Microsoft Copilot, Google Gemini et Claude
Les modèles à poids ouverts que vous pouvez exécuter
À poids ouverts signifie que les fichiers du modèle sont publiés : vous pouvez l'exécuter vous-même. Données d'entraînement ouvertes signifie que les données sont aussi publiées : vous pouvez vérifier comment le modèle a été construit. Le tableau a été établi le 15 octobre 2026 à partir des fiches des modèles, des fichiers de licence et des annonces des éditeurs.
- MistralMistral Large 3, Mistral Small 4, Mistral Medium 3.5
- Éditeur
- Mistral AI
- Pays
- France
- Données d'entraînement ouvertes
- Non
- Licence
- Apache-2.0, Modified MIT
Large 3 et Small 4 sont sous Apache-2.0. Medium 3.5 et Devstral 2 utilisent une licence MIT modifiée qui n'accorde aucun droit à une entreprise dont le chiffre d'affaires mensuel consolidé mondial dépasse 20 millions USD. Large 4 a été annoncé le 6 octobre 2026 et sa licence n'est pas encore précisée. Mistral annonce la publication des poids d'ici fin octobre.
- ApertusApertus 1.5 70B, Apertus 1.5 8B
- Éditeur
- EPFL, ETH Zurich, CSCS
- Pays
- Suisse
- Données d'entraînement ouvertes
- Oui
- Licence
- Apache-2.0
Entièrement ouvert : les poids, les données d'entraînement et l'ensemble des détails de l'entraînement sont publiés. La version 1.5 a suivi le 24 juillet 2026.
- EuroLLMEuroLLM-22B, EuroLLM-9B
- Éditeur
- IST Lisbon, Unbabel, University of Edinburgh et al.
- Pays
- Union européenne
- Données d'entraînement ouvertes
- Non confirmé
- Licence
- Apache-2.0
Construit par des universités et des entreprises européennes et financé par l'UE. Sa fiche le présente comme le meilleur modèle entièrement ouvert conçu dans l'UE sur les benchmarks généraux. Les données multilingues de pré-entraînement web (EuroWeb) et les données d'instruction (EuroBlocks) sont publiques sur Hugging Face. Nous n'avons pas confirmé que le reste des données d'entraînement est public.
- TeukenTeuken-7B-instruct-v0.6
- Éditeur
- OpenGPT-X: Fraunhofer, FZ Jülich, TU Dresden, DFKI
- Pays
- Allemagne
- Données d'entraînement ouvertes
- Non confirmé
- Licence
- CC-BY-NC-4.0, Apache-2.0
Construit en Allemagne pour 24 langues de l'UE. La version la plus récente, Teuken-7B-instruct-v0.6 (juillet 2025), est sous CC-BY-NC-4.0, qui exclut l'usage commercial. La version sous Apache-2.0 est l'ancienne v0.4 (octobre 2024).
- OLMoOlmo 3.1 32B Think, Olmo 3.1 32B Instruct
- Éditeur
- Ai2
- Pays
- États-Unis
- Données d'entraînement ouvertes
- Oui
- Licence
- Apache-2.0
Entièrement ouvert : les poids, les données d'entraînement (Dolma 3 et Dolci), le code d'entraînement et les checkpoints sont publiés.
- GemmaGemma 4 31B, Gemma 4 26B-A4B, Gemma 4 12B
- Éditeur
- Pays
- États-Unis
- Données d'entraînement ouvertes
- Non
- Licence
- Apache-2.0
Gemma 4 (2 avril 2026) est sous Apache-2.0. Les versions antérieures de Gemma utilisaient la licence propre à Google.
- gpt-ossgpt-oss-120b, gpt-oss-20b
- Éditeur
- OpenAI
- Pays
- États-Unis
- Données d'entraînement ouvertes
- Non
- Licence
- Apache-2.0
Apache-2.0. OpenAI publie les poids et le code de référence, mais pas les données d'entraînement.
- Llama, MuseMuse Glimmer 30B, Llama 4 Scout, Llama 4 Maverick
- Éditeur
- Meta
- Pays
- États-Unis
- Données d'entraînement ouvertes
- Non
- Licence
- Llama 4 Community License, Apache-2.0
Llama 4 utilise la Llama 4 Community License. Sa politique d'utilisation acceptable refuse la licence des modèles multimodaux Llama 4 aux personnes domiciliées dans l'UE et aux entreprises dont l'établissement principal se trouve dans l'UE. Muse Glimmer 30B (10 août 2026) est sous Apache-2.0.
- DeepSeekDeepSeek-V4-Pro, DeepSeek-V4-Flash, DeepSeek-V4.1-Flash
- Éditeur
- DeepSeek
- Pays
- Chine
- Données d'entraînement ouvertes
- Non
- Licence
- MIT
Licence MIT. DeepSeek publie les poids, un rapport technique et une partie du code d'infrastructure, mais pas les données d'entraînement.
- GLMGLM-5.3, GLM-5.3-Flash
- Éditeur
- Zhipu AI (Z.ai)
- Pays
- Chine
- Données d'entraînement ouvertes
- Non
- Licence
- GLM-5.3 License, MIT
GLM-5.3 est sous une licence de type MIT assortie d'une condition : une entreprise qui vend un accès hébergé au modèle (Model-as-a-Service) et dont le chiffre d'affaires du groupe dépasse 10 milliards USD sur 12 mois doit passer l'examen de sécurité de Z.AI avant tout usage commercial. GLM-5.3-Flash et GLM-5.2 sont sous MIT.
- QwenQwen3.8-2.4T-A95B, Qwen3.8-27B, Qwen3.8-Flash-Next
- Éditeur
- Alibaba
- Pays
- Chine
- Données d'entraînement ouvertes
- Non
- Licence
- Qwen3.8-Max License, Qwen Community License 1.0, Apache-2.0
Qwen3.8-27B est sous Apache-2.0. Pour Qwen3.8-2.4T-A95B, une entreprise qui vend un accès hébergé au modèle (Model-as-a-Service) ou un assistant de travail IA a besoin d'une licence distincte au-delà de 50 millions USD de chiffre d'affaires sur 12 mois. Pour Qwen3.8-Flash-Next, il en faut une quel que soit le chiffre d'affaires.
- KimiKimi K3, Kimi K2.7 Code
- Éditeur
- Moonshot AI
- Pays
- Chine
- Données d'entraînement ouvertes
- Non
- Licence
- Kimi K3 License, Modified MIT
Kimi K3 : une entreprise qui vend un accès hébergé au modèle (Model-as-a-Service) a besoin d'un accord distinct au-delà de 20 millions USD de chiffre d'affaires sur 12 mois. Un produit comptant plus de 100 millions d'utilisateurs mensuels ou 20 millions USD de chiffre d'affaires mensuel doit afficher le nom Kimi K3.
Coder avec des modèles ouverts
Les modèles à poids ouverts peuvent déjà piloter un agent de développement, mais les meilleurs modèles fermés restent devant. Sur Terminal-Bench 4.0 (données mises à jour le 6 octobre 2026), le meilleur résultat à poids ouverts est GLM-5.3, avec 41,8 % des tâches résolues. Le meilleur résultat fermé est Claude Opus 5.5, avec 64,8 %. Les deux ont tourné avec Claude Code comme agent.
Par défaut, Ollama dimensionne la fenêtre de contexte selon la mémoire GPU : 4k tokens sous 24 Gio, 32k de 24 à 48 Gio et 256k à partir de 48 Gio (sa documentation, consultée le 15 octobre 2026). La même documentation recommande au moins 64 000 tokens pour les outils de développement : agrandissez donc la fenêtre avant de lancer un agent de développement. La documentation d'Aider précise que pour les grands dépôts, même la carte du dépôt peut ne pas tenir dans la fenêtre de contexte d'un modèle.
Documentation d'Aider : carte du dépôtOutils de développement open source compatibles avec un modèle local
Rédiger avec des modèles ouverts
Une interface de chat placée devant un modèle à poids ouverts sur votre propre serveur peut rédiger et reformuler des textes sans qu'aucun prompt ne quitte vos serveurs. Au classement texte d'Arena (consulté le 15 octobre 2026), le meilleur modèle à poids ouverts, Kimi K3, est classé 17e avec un score de 1488. Le modèle classé premier est fermé, obtient 1525 et reste marqué comme provisoire. La fourchette de classement de Kimi K3 va de la 9e à la 29e place : l'ordre n'est donc pas exact.
Des interfaces de chat que vous pouvez exploiter vous-même
- LibreChatMIT
- AnythingLLMMIT
- Hugging Face Chat UIApache-2.0
- JanApache-2.0
- big-AGIMIT
- Open WebUIOpen WebUI License
- OnyxMIT, Onyx Enterprise License
- LobeHubLobeHub Community License
Open WebUI, Onyx et LobeHub ajoutent leurs propres conditions à la licence : lisez-les avant d'en déployer une.
Classements publics
Des agents de développement résolvent des tâches dans un terminal. Chaque résultat porte sur un agent et un modèle ensemble. Données mises à jour le 6 octobre 2026.
Classe 415 modèles à partir de 8 804 675 votes d'utilisateurs. Consulté le 15 octobre 2026.
Note les modèles sur dix évaluations dans son Intelligence Index (v4.3.2) et tient un classement distinct pour les modèles à poids ouverts. Consulté le 15 octobre 2026.
- SWE-bench VerifiedPas à jour
L'entrée la plus récente date du 26 février 2026 : les modèles publiés après cette date n'y figurent pas.
- Aider PolyglotPas à jour
La dernière entrée date du 3 octobre 2025.
- LiveCodeBenchPas à jour
Ses données couvrent des problèmes de mai 2023 à avril 2025 et des modèles publiés jusqu'à mi-2025 : il ne peut donc pas classer les modèles de 2026.
Votre installation est-elle souveraine ?
Évaluez cette fonctionnalité et le reste de votre stack grâce à l'évaluation gratuite.